Duże modele językowe (LLM) są bazą wielu nowoczesnych systemów opartych na sztucznej inteligencji. Ich cechy to ogromne liczby parametrów i zdolności do rozumienia kontekstu, generowania naturalnego języka oraz adaptowania się do różnorodnych zadań. Jednak ta moc ma swoją cenę. Modele potrzebują dużej mocy obliczeniowej i generują wysokie koszty. Dodatkowo, ich inferencja, czyli generowanie odpowiedzi, może być powolna, jeśli nie zostanie odpowiednio zoptymalizowana.
Optymalizacja LLM-ów to zestaw technik, które pozwalają zachować wysoką jakość generowanych odpowiedzi, a jednocześnie zmniejszyć zużycie zasobów, czas odpowiedzi i koszty. Oznacza to nie tylko przyspieszenie działania modelu, ale także redukcję zużycia energii, co staje się coraz ważniejsze przy rosnących rozmiarach modeli i skali ich zastosowania.
W tym artykule opisujemy popularne techniki optymalizacji samej architektury, jak i inferencji.
Optymalizacja architektury i parametrów modeli LLM
Jednym z najważniejszych sposobów poprawy efektywności systemów opartych na dużych modelach językowych jest optymalizacja samego modelu, czyli jego parametrów, struktury czy sposobu trenowania. Oznacza to modyfikacje, które pozwalają zmniejszyć rozmiar modelu, ograniczyć koszt jego trenowania lub ułatwić dostosowanie go do konkretnych zadań.
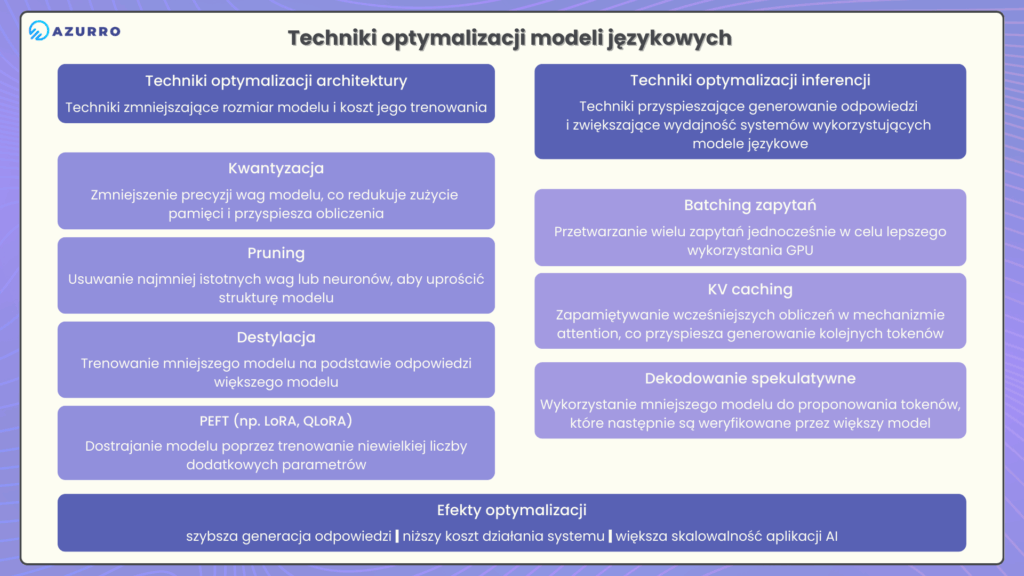
Techniki opisane w tym rozdziale dotyczą właśnie tej warstwy optymalizacji. Obejmują one między innymi kompresję modeli, która zmniejsza zapotrzebowanie na pamięć i obliczenia, destylację wiedzy, pozwalającą tworzyć mniejsze modele uczące się od większych, oraz metody PEFT, które umożliwiają dostrajanie modeli. Podejścia te różnią się mechanizmem działania, ale ich wspólnym celem jest zwiększenie efektywności modeli przy zachowaniu możliwie wysokiej jakości odpowiedzi.
Kompresja modelu: kwantyzacja i pruning
Jednym z najważniejszych sposobów zmniejszania kosztów działania dużych modeli językowych jest kompresja modelu. Oznacza to zmniejszenie jego rozmiaru lub liczby operacji potrzebnych do wygenerowania odpowiedzi. Dzięki temu model zużywa mniej pamięci, działa szybciej i może być uruchamiany na tańszej infrastrukturze.
Dwa najczęściej stosowane podejścia to kwantyzacja (quantization) oraz pruning. Przegląd tych metod przedstawia m.in. artykuł “A Survey on Model Compression for Large Language Models”.
Kwantyzacja
Kwantyzacja polega na zmniejszeniu precyzji liczb, które opisują parametry modelu. W kontekście sieci neuronowych precyzja oznacza, ile informacji przechowuje liczba używana do zapisu wag modelu. Im więcej bitów ma taka liczba, tym dokładniej może reprezentować wartości, ale jednocześnie zajmuje więcej pamięci i wymaga więcej obliczeń.
W standardowych implementacjach duże modele językowe przechowują swoje parametry jako liczby zmiennoprzecinkowe o wysokiej precyzji, na przykład FP32 lub FP16. Liczba FP32 wykorzystuje 32 bity pamięci, a FP16 16 bitów, dzięki czemu zajmuje połowę mniej miejsca.
W kwantyzacji stosuje się jeszcze prostsze reprezentacje liczb, takie jak INT8 lub 4-bit. W przypadku INT8 każda liczba zajmuje tylko 8 bitów, a w przypadku 4-bit liczba dostępnych wartości jest jeszcze mniejsza, ale model może być znacznie bardziej kompaktowy. Oznacza to, że parametry modelu zajmują mniej pamięci, a operacje matematyczne mogą być wykonywane szybciej. W przypadku dużych modeli różnica może być bardzo wyraźna.
Przykładem zastosowania kwantyzacji są polskie modele z rodziny Bielik, rozwijane w ramach projektu SpeakLeash. Przy publikacji kolejnych wersji modeli na platformie Hugging Face udostępniane są nie tylko ich pełne warianty, ale też skwantyzowane wersje, które wymagają mniej pamięci i mogą działać szybciej na słabszym sprzęcie. Użytkownicy mogą wybrać wersję modelu dopasowaną do swojej infrastruktury, np. 4-bitową, 5-bitową, 6-bitową czy 8-bitową, w zależności od dostępnej mocy obliczeniowej.
Pruning
Drugą techniką kompresji jest pruning, czyli “przycinanie” modelu – usuwanie części parametrów, które mają niewielki wpływ na jego działanie. W bardzo dużych sieciach neuronowych, takich jak modele językowe, wiele wag jest bardzo małych lub rzadko wykorzystywanych w obliczeniach. Usunięcie takich elementów pozwala zmniejszyć złożoność modelu bez dużej utraty jakości.
Pruning polega na identyfikowaniu mało istotnych połączeń lub wag, a następnie ich usunięciu. Dzięki temu model staje się mniejszy i bardziej efektywny obliczeniowo.
W systemach pruning często jest łączony z innymi metodami, takimi jak kwantyzacja czy destylacja modeli, aby jeszcze bardziej zmniejszyć rozmiar modelu i koszt jego działania.
Jednak jeśli usuniemy zbyt wiele parametrów, model może stracić część swojej zdolności do generowania poprawnych odpowiedzi. Dlatego pruning często wymaga ponownego dostrojenia modelu.
Destylacja modeli
Kompresja modeli, jak wyżej opisana kwantyzacja czy pruning, polega na upraszczaniu istniejącego modelu. Istnieje jednak inne podejście do optymalizacji: zamiast zmniejszać już wytrenowany model, można wytrenować nowy, mniejszy model, który uczy się od większego. Ta technika nazywa się destylacją modeli (knowledge distillation).
W destylacji większy model generuje odpowiedzi lub przewiduje prawdopodobieństwa kolejnych tokenów. Zadaniem mniejszego modelu jest nauczyć się naśladować jego zachowanie. W efekcie mniejszy model może osiągać zbliżoną jakość odpowiedzi, mimo że ma znacznie mniej parametrów i jest tańszy.
W klasycznej wersji destylacji mniejszy model uczy się przewidywać te same rozkłady prawdopodobieństwa tokenów, które generuje większy model. Dzięki temu nie uczy się wyłącznie poprawnej odpowiedzi, ale także tego, jakie alternatywy były prawdopodobne z punktu widzenia większego modelu. Taki sposób trenowania pozwala zachować dużą część wiedzy większego modelu w znacznie mniejszej architekturze.
Największą zaletą destylacji jest możliwość stworzenia modelu, który jest znacznie mniejszy i szybszy, ale nadal zachowuje dużą część zdolności większego modelu. Jednocześnie warto pamiętać, że mniejszy model rzadko osiąga dokładnie taką samą jakość jak model, od którego się uczył, szczególnie w bardziej złożonych zadaniach wymagających głębokiego rozumowania. Dlatego destylacja jest najczęściej stosowana wtedy, gdy priorytetem jest szybkość działania i koszt, a niewielka utrata jakości jest akceptowalna.
Destylacja może też stanowić element większego procesu optymalizacji. Mniejszy model uzyskany w ten sposób może być później dodatkowo zoptymalizowany przy użyciu innych technik, takich jak kwantyzacja czy pruning, co pozwala jeszcze bardziej zmniejszyć związane z nim koszty.
Parameter-Efficient Fine-Tuning (PEFT)
W wielu zastosowaniach modeli językowych konieczne jest ich dostosowanie do konkretnego zadania, na przykład do pracy z dokumentacją firmy, obsługi klienta czy analizy tekstów medycznych. Najprostszym sposobem byłoby przeprowadzenie pełnego fine-tuningu, czyli dalszego trenowania modelu na nowych danych. W takim podejściu aktualizowane są wszystkie parametry modelu.
Problem polega na tym, że współczesne modele językowe mają miliardy parametrów, a ich trenowanie wymaga dużych zasobów obliczeniowych. W wielu przypadkach pełny fine-tuning jest więc bardzo kosztowny, dlatego stosuje się technikę parameter-efficient fine-tuning (PEFT). Zamiast aktualizować wszystkie parametry modelu, trenuje się jedynie niewielką ich część lub dodaje się do modelu małe komponenty adaptacyjne. Dzięki temu można dostosować model do nowego zadania przy znacznie mniejszym koszcie i mniejszym zapotrzebowaniu na pamięć.
Jedną z najbardziej znanych metod tego typu jest LoRA (Low-Rank Adaptation). W tym podejściu oryginalne parametry modelu pozostają niezmienione, a proces trenowania dotyczy tylko niewielkich macierzy dodawanych do niektórych warstw sieci. Liczba trenowanych parametrów jest bardzo mała w porównaniu z pełnym modelem, co pozwala dostosować duży model językowy przy użyciu znacznie mniejszej liczby zasobów. Jednym z rozwinięć tego podejścia jest QLoRA, które łączy LoRA z kwantyzacją modelu bazowego. Model przechowywany jest w niskiej precyzji (np. 4-bit), a trenowane są jedynie niewielkie części, co dodatkowo zmniejsza zapotrzebowanie na pamięć podczas dostrajania.
Techniki PEFT są stosowane w praktyce, ponieważ pozwalają tworzyć wiele wyspecjalizowanych wersji jednego modelu bazowego bez konieczności trenowania każdego z nich od początku. Jednak takie modele mają pewne ograniczenia. Ponieważ większość parametrów modelu pozostaje niezmieniona, zakres możliwych zmian w zachowaniu modelu jest mniejszy niż w przypadku pełnego fine-tuningu. Oznacza to, że PEFT sprawdza się najlepiej wtedy, gdy celem jest dostosowanie modelu do konkretnego zadania lub stylu odpowiedzi, a nie ogólna zmiana jego wiedzy lub zdolności.
Optymalizacja inferencji modeli językowych
Po dostrojeniu i ewentualnej kompresji modelu kolejnym wyzwaniem staje się jego wydajne uruchamianie w praktycznych systemach. Ten etap nazywa się inferencją, czyli procesem, w którym wytrenowany model generuje odpowiedź na podstawie zapytania użytkownika.
Inferencja różni się od trenowania modelu pod kilkoma względami. Trening jest procesem kosztownym obliczeniowo, ale wykonywanym stosunkowo rzadko, zwykle tylko wtedy, gdy model jest tworzony lub ponownie trenowany. Inferencja natomiast zachodzi za każdym razem, gdy system AI odpowiada na zapytanie. W aplikacjach produkcyjnych może to oznaczać tysiące lub miliony zapytań dziennie. Nawet niewielkie usprawnienia na tym etapie mogą znacząco zmniejszyć koszty działania systemu oraz skrócić czas oczekiwania na odpowiedź.
Optymalizacja inferencji obejmuje techniki, które pozwalają lepiej wykorzystać dostępne zasoby obliczeniowe i przyspieszyć generowanie tekstu. Dotyczą one między innymi sposobu przetwarzania zapytań, zarządzania pamięcią modelu czy usprawniania procesu generowania kolejnych tokenów. Odpowiednia optymalizacja może zmniejszyć latencję systemu, czyli czas między wysłaniem zapytania a otrzymaniem odpowiedzi, oraz obniżyć koszty infrastruktury potrzebnej do obsługi dużej liczby użytkowników.
Batching zapytań
Jedną z najprostszych technik przyspieszania działania systemów opartych na modelach językowych jest batching zapytań. Polega on na przetwarzaniu wielu zapytań jednocześnie zamiast obsługiwania każdego z nich osobno.
Modele językowe są zwykle uruchamiane na procesorach graficznych (GPU). GPU są zaprojektowane do wykonywania dużej liczby operacji równolegle. Jeśli model obsługuje tylko jedno zapytanie naraz, część dostępnej mocy obliczeniowej pozostaje niewykorzystana. Batching pozwala lepiej ją wykorzystać, ponieważ model przetwarza wiele sekwencji tekstu w jednej operacji.
W systemach produkcyjnych batching często polega na tym, że zapytania od użytkowników są przez krótki czas zbierane w kolejce, a następnie przekazywane do modelu jako jedna paczka danych. Dzięki temu wiele sekwencji tokenów może być przetworzonych jednocześnie. W rezultacie rośnie przepustowość systemu, czyli liczba zapytań, które można obsłużyć w danym czasie.
KV caching
Kolejną ważną techniką optymalizacji inferencji jest KV caching (Key-Value caching). Metoda ta przyspiesza generowanie tekstu poprzez zapamiętywanie części obliczeń wykonanych przez model podczas wcześniejszych kroków.
Aby zrozumieć, dlaczego jest to potrzebne, warto przyjrzeć się temu, jak modele językowe generują tekst. W większości współczesnych modeli odpowiedź powstaje token po tokenie. Token to najmniejsza jednostka tekstu przetwarzana przez model, która może odpowiadać całemu słowu lub jego fragmentowi.
Podczas generowania każdego nowego tokenu model analizuje cały dotychczasowy kontekst, czyli wszystkie wcześniejsze tokeny w sekwencji. Mechanizm odpowiedzialny za to porównywanie elementów kontekstu nazywa się attention. Dzięki niemu model może określić, które fragmenty wcześniejszego tekstu są najważniejsze dla wygenerowania kolejnego tokenu.
Problem polega na tym, że bez dodatkowych optymalizacji model musiałby za każdym razem ponownie obliczać reprezentacje wszystkich wcześniejszych tokenów. Przy dłuższych odpowiedziach oznaczałoby to dużą liczbę powtarzających się obliczeń. Właśnie dlatego stosuje się KV caching. Podczas pierwszego przetwarzania tokenów model zapisuje w pamięci wyniki części obliczeń związanych z mechanizmem attention, czyli klucze (keys) i wartości (values). Gdy generowany jest kolejny token, model może wykorzystać zapisane wcześniej wyniki zamiast liczyć je ponownie. Dzięki temu liczba potrzebnych operacji znacząco się zmniejsza.
KV caching pozwala zmniejszyć czas generowania długich odpowiedzi. Skuteczność tej metody rośnie wraz z długością generowanej sekwencji, dlatego jest szczególnie ważna w aplikacjach takich jak chatboty, systemy konwersacyjne czy narzędzia do generowania długich tekstów.
Dekodowanie spekulatywne
Jedną z nowszych technik przyspieszania generowania tekstu w modelach językowych jest dekodowanie spekulatywne (speculative decoding). Podejście to polega na wykorzystaniu dwóch modeli jednocześnie: dużego, dokładnego modelu oraz mniejszego, szybszego modelu pomocniczego.
W tym podejściu mniejszy model najpierw generuje kilka kolejnych tokenów jako wstępną propozycję odpowiedzi. Następnie duży model sprawdza, czy te tokeny są zgodne z jego własnymi przewidywaniami. Jeśli tak, mogą zostać zaakceptowane bez ponownego generowania przez duży model. Jeśli nie, duży model generuje poprawną dalszą wersję tekstu.
Dekodowanie spekulatywne może zwiększyć szybkość generowania tekstu, ponieważ część tokenów jest generowana przez mniejszy model, który działa szybciej i wymaga mniej zasobów. Jednocześnie końcowa jakość odpowiedzi pozostaje zbliżona do tej generowanej przez większy model, ponieważ to on ostatecznie weryfikuje wynik.
Podobnie jak w przypadku innych technik optymalizacji, speculative decoding wiąże się z pewnymi wyzwaniami. Wprowadza dodatkową złożoność systemu, ponieważ wymaga utrzymywania dwóch modeli zamiast jednego. Skuteczność tej metody zależy także od tego, jak dobrze mniejszy model potrafi przewidywać kolejne tokeny w sposób zgodny z większym modelem.
Mimo tego ta technika jest coraz częściej stosowana w nowoczesnych systemach inferencyjnych dla LLM, ponieważ pozwala zmniejszyć latencję generowania odpowiedzi przy zachowaniu wysokiej jakości tekstu.
Podsumowanie
Optymalizacja dużych modeli językowych może odbywać się na kilku poziomach. Część technik dotyczy samego modelu, czyli jego parametrów, rozmiaru i sposobu dostrajania. Należą do nich m.in. kompresja modeli, destylacja czy metody PEFT, które pozwalają ograniczyć koszt trenowania i wdrażania modeli.
Inne podejścia koncentrują się na optymalizacji inferencji, czyli sposobu, w jaki model działa w systemie produkcyjnym. Techniki takie jak batching zapytań, KV caching czy dekodowanie spekulatywne pozwalają lepiej wykorzystać dostępne zasoby obliczeniowe i skrócić czas generowania odpowiedzi.
Często stosuje się kombinację kilku metod, dobierając je do konkretnych cech projektu, takich jak dostępna infrastruktura, wymagania dotyczące latencji czy koszt działania systemu. Odpowiednia optymalizacja może znacząco zwiększyć efektywność systemów opartych na LLM, bez konieczności trenowania coraz większych modeli.