Wdrażanie systemów opartych na sztucznej inteligencji wiąże się z kosztami, które nie ograniczają się wyłącznie do trenowania modeli. Na całkowity koszt AI składają się m.in. wydatki na infrastrukturę obliczeniową, inferencję, przechowywanie i transfer danych, utrzymanie środowisk oraz szereg kosztów pośrednich, które często mogą być niewidoczne na etapie planowania.
W tym artykule omawiamy strukturę wydatków związanych z AI, przedstawiamy przykłady implementacji oraz opisujemy podejścia do ograniczania kosztów.
Struktura kosztów wdrażania AI
Koszty systemów opartych na sztucznej inteligencji są rozłożone na wiele etapów i nie ograniczają się do jednorazowego wydatku. Obejmują zarówno koszty trenowania modeli, jak i długoterminowe wydatki na uruchamianie, utrzymanie danych oraz infrastruktury. Wraz ze wzrostem skali modeli i liczby wdrożeń, struktura kosztów przesuwa się z wydatków jednorazowych w stronę kosztów operacyjnych, które narastają w czasie i często są trudniejsze do kontrolowania.
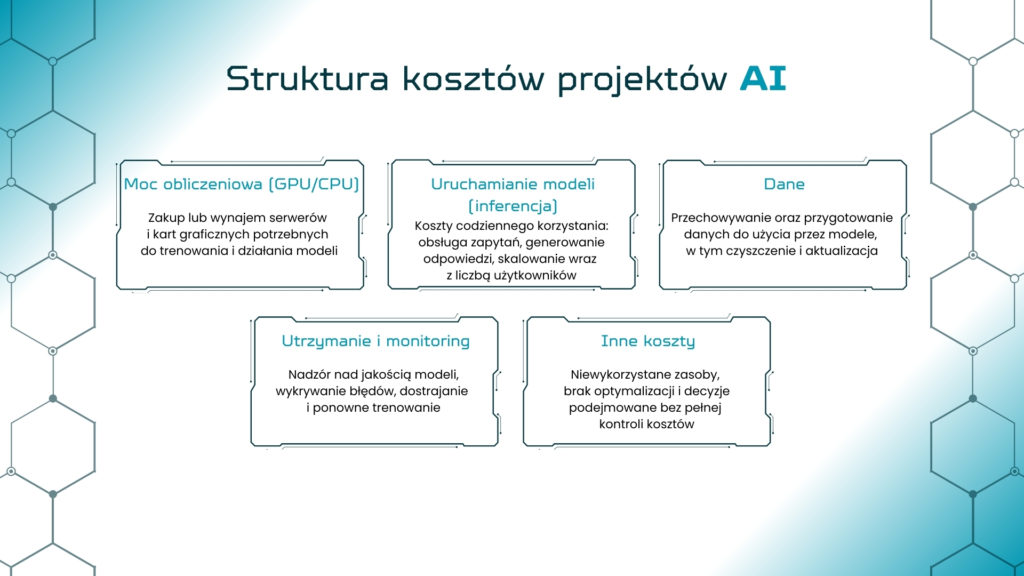
Trenowanie modeli jest zwykle najbardziej widocznym kosztem na początku projektu. Obejmuje ono przede wszystkim wykorzystanie akceleratorów obliczeniowych, takich jak np. GPU, oraz czas ich pracy. Dane z raportu AI Index Report wskazują, że koszty trenowania dużych modeli wzrosły znacząco na przestrzeni ostatnich lat. Przykładowo, szacunkowe koszty trenowania modeli takich jak GPT-3 i GPT-4 osiągały dziesiątki milionów dolarów, a w przypadku nowszych projektów liczone są już w setkach milionów.
W praktyce jednak wiele organizacji nie trenuje modeli od zera, lecz decyduje się na ich dostrajanie (fine-tuning) pod własne dane i konkretne potrzeby. Taki proces, choć tańszy niż pełny trening dużego modelu, nadal generuje spore koszty obliczeniowe, zwłaszcza gdy obejmuje duże zbiory danych lub jest wykonywany cyklicznie. Nawet dostrajanie modeli na poziomie firmowym wymaga znaczących zasobów infrastrukturalnych. W efekcie trening i dostrajanie modeli rzadko są jednorazowym wydatkiem, a częściej stają się powtarzalnym elementem kosztowym.
Po wdrożeniu modelu na produkcję kluczową rolę odgrywają koszty inferencji, czyli uruchamiania modelu w odpowiedzi na zapytania użytkowników lub systemów. Koszty te są często rozliczane na podstawie wykorzystania. Ceny za milion tokenów mogą być różne w zależności od modelu i wariantu usługi, co wpływa na końcowy koszt korzystania z AI w aplikacjach produkcyjnych. Takie koszty stają się szczególnie ważne, gdy modele działają w dużej skali.
Istotnym, a często niedoszacowanym elementem są koszty związane z danymi. Obejmują one nie tylko przechowywanie danych, lecz także np. transfer danych pomiędzy regionami chmury, kopiowanie ich między środowiskami czy utrzymywanie wielu wersji tych samych zbiorów. Dodatkowo, w praktycznych wdrożeniach często konieczne jest przygotowanie danych, czyli ich oczyszczenie, deduplikacja czy formatowanie, co generuje dodatkowe koszty związane z pracą zespołów zajmującymi się danymi i zasobami.
Kolejnym kosztem jest infrastruktura, zarówno chmurowa, jak i sprzętowa. Organizacje mogą korzystać z modeli opartych wyłącznie na chmurze, inwestować we własny sprzęt lub łączyć oba podejścia w modelu hybrydowym. Chmura oferuje elastyczność rozliczania na zasadzie “pay-as-you-go”, ale przy stałym i dużym obciążeniu może być droższa niż własna infrastruktura, która z kolei wymaga wysokich wydatków początkowych. Analizy rynku wskazują, że coraz więcej organizacji rozważa podejścia hybrydowe lub korzystanie z chmur kilku dostawców jednocześnie.
Oprócz kosztów bezpośrednich istotną rolę odgrywają koszty pośrednie, które często nie są uwzględniane w początkowych kalkulacjach. Mogą one obejmować brak wyłączania środowisk testowych, gdy nie są już potrzebne, nadmierne rezerwowanie zasobów obliczeniowych czy nieoptymalne potoki przetwarzania danych. W środowiskach chmurowych część zasobów może pozostawać niewykorzystana, dlatego potrzebny jest monitoring i optymalizacja.
Praktyczne przykłady i case studies
Jednym z najczęściej analizowanych tematów kosztowych jest porównanie infrastruktury chmurowej i on-premise dla obciążeń związanych z AI. W raporcie On-Premise vs Cloud: Generative AI Total Cost of Ownership opublikowanym przez Lenovo przedstawiono szczegółową analizę TCO (Total Cost of Ownership, czyli całkowitego kosztu posiadania infrastruktury w całym okresie jej użytkowania) dla dużych modeli opartych na GPU NVIDIA H100. Autorzy pokazują, że przy stałym i wysokim obciążeniu moment, gdy infrastruktura on-premise staje się tańsza niż rozwiązanie chmurowe pojawia się po 12–18 miesiącach. Kluczowym czynnikiem jest struktura kosztów: wysoki koszt początkowy zakupu sprzętu (CapEx) równoważony jest niższymi, przewidywalnymi kosztami operacyjnymi w dłuższej perspektywie czasu.
Podobne wnioski pojawiają się w innych analizach, które opisują moment, w którym wydatki na infrastrukturę AI zaczynają rosnąć szybciej, niż zakładano na etapie planowania. W artykule AI Infrastructure Inflection Point: 60% Cloud Costs Signal Time to Go Private pokazano, że gdy miesięczne koszty chmury przekraczają około 60-70% potencjalnego kosztu własnej infrastruktury, organizacje zaczynają szukać alternatywnych rozwiązań. Najczęściej oznacza to przeniesienie części obciążeń do własnej infrastruktury lub przejście na model hybrydowy, który łączy wykorzystanie chmury z zasobami lokalnymi. Analiza obejmuje okres 3–5 lat i wskazuje, że przy stabilnym, przewidywalnym zapotrzebowaniu na moc obliczeniową model oparty wyłącznie na chmurze prowadzi do systematycznego wzrostu kosztów, którego nie da się skutecznie ograniczyć wyłącznie poprzez optymalizację wykorzystania zasobów.
Ten sam problem opisują także inne artykuły porównujące chmurę z infrastrukturą on-premise. W materiale Cloud vs On-Premise Infrastructure: Comparison Guide wskazano, że w latach 2024–2025 wydatki na chmurę rosły szybciej, niż zakładano na etapie planowania. Główną przyczyną był intensywny wzrost wykorzystania GPU do obliczeń oraz dodatkowe koszty związane z przesyłaniem danych. Chmura nadal sprawdza się tam, gdzie zapotrzebowanie na zasoby zmienia się w czasie, jednak przy długotrwałym, stałym wykorzystaniu infrastruktury AI koszty stają się coraz trudniejsze do uzasadnienia z ekonomicznego punktu widzenia.
Istotnym aspektem dyskusji o kosztach są także rzeczywiste ceny GPU, które są jednym z głównych źródeł kosztów projektów AI. Zestawienia przygotowane np. przez Jarvis Labs czy Intuition Labs pokazują, że zakup jednego GPU NVIDIA H100 kosztuje około 25-30 tys. USD. W chmurze rozpiętość cen jest jeszcze większa i w zależności od dostawcy może różnić się nawet kilkunastokrotnie. W praktyce oznacza to, że dwie organizacje korzystające z tego samego typu GPU mogą ponosić zupełnie różne koszty wyłącznie dlatego, że wybrały innego dostawcę infrastruktury.
Przytoczone przykłady pokazują, że obniżanie kosztów AI rzadko polega na jednej, prostej decyzji. W praktyce jest to zestaw powiązanych wyborów dotyczących infrastruktury, długofalowego spojrzenia na całkowite koszty oraz świadomego rozdzielenia tego, co powinno działać w chmurze, a co poza nią.
Koszty jako bariera skalowania systemów AI
W momencie, gdy projekty AI zaczynają być używane na codzień, koszty infrastruktury zaczynają odgrywać coraz większą rolę w decyzjach dotyczących dalszego rozwoju. Oznacza to, że zespoły coraz częściej muszą ograniczać zakres wdrożeń, zmniejszać częstotliwość uruchamiania modeli lub odkładać kolejne zastosowania AI na później. Brak kontroli nad kosztami może nie prowadzić do całkowitego wyłączenia systemów, ale często skutkuje ich „zamrożeniem” na obecnym poziomie, bez możliwości dalszego skalowania.
W praktyce może zdarzyć się tak, że system działa poprawnie, ale jego dalsze rozszerzanie okazuje się zbyt kosztowne. W takich przypadkach zespoły rezygnują z kolejnych funkcji opartych na AI, ograniczają liczbę użytkowników lub zmniejszają częstotliwość uruchamiania modeli, aby utrzymać koszty na akceptowalnym poziomie. Zamiast skalować rozwiązania, organizacje skupiają się na utrzymaniu obecnego stanu, traktując AI jako koszt stały, a nie elastyczny element systemu, który można rozwijać wraz z potrzebami.
W odpowiedzi na rosnące koszty coraz więcej organizacji zaczyna wprowadzać formalne podejście do kontroli wydatków na AI. Firmy wdrażają praktyki określane jako FinOps dla AI, czyli bieżące monitorowanie zużycia zasobów, przypisywanie kosztów do konkretnych zespołów lub przypadków użycia oraz ustalanie limitów budżetowych na etapie projektowania systemów. Popularne stają się też modele hybrydowe, w których najbardziej kosztowne i przewidywalne elementy działania AI przenoszone są poza chmurę, a chmura wykorzystywana jest głównie w przypadku zadań, które generują zmienne obciążenie. Celem tych działań stabilizacja kosztów, tak aby dalszy rozwój systemów AI nie był blokowany przez niekontrolowany wzrost wydatków.
Koszty stają się jednym z głównych czynników decydujących o tym, czy systemy AI mogą być dalej rozwijane, czy pozostają na niezmienionym poziomie przez dłuższy czas. Organizacje, które traktują koszty jako element planowania już na wczesnym etapie, są w stanie stopniowo rozszerzać zastosowania AI i unikać gwałtownych ograniczeń. Tam, gdzie takiego podejścia brakuje, rozwój systemów AI często spowalnia nie z powodów technologicznych, lecz z powodu rosnących i trudnych do przewidzenia wydatków.
Podsumowanie
Koszty związane z wdrażaniem i utrzymaniem systemów AI rzadko są głównym problemem na początku projektu. W wielu przypadkach ujawniają się dopiero, gdy rozwiązania zaczynają być używane na co dzień i stopniowo się rozwijają. Na tym etapie infrastruktura i sposób jej wykorzystania mogą zacząć wpływać na kierunek dalszego rozwoju systemów AI.
Częstym wyzwaniem nie jest sam poziom kosztów, lecz ich zmienność oraz trudność w ich przewidywaniu. Gdy wydatki rosną szybciej, niż zakładano, zespoły mogą być zmuszone do ograniczania zakresu systemów lub odkładania kolejnych etapów wdrożeń.
Stabilny rozwój projektów opartych o AI wymaga świadomego podejścia do kosztów już na etapie projektowania systemów. Nie chodzi o maksymalne obniżanie wydatków, lecz o ich przewidywalność i dopasowanie do realnego sposobu użycia modeli. W przypadkach, gdy to się udaje, AI może być rozwijana stopniowo i bez gwałtownych ograniczeń. Tam, gdzie tego brakuje, bariery kosztowe mogą stać się jednym z hamulców dalszego rozwoju.