Człowiek odbiera świat za pomocą wzroku, słuchu i innych zmysłów. Potrafimy rozpoznać przedmioty na zdjęciu, zrozumieć wypowiedziane słowa czy zauważyć ruch w nagraniu bez zastanawiania się nad tym. Model AI nie doświadcza rzeczywistości w taki sam sposób. Otrzymuje dane, które trzeba przekształcić do postaci możliwej do matematycznego przetwarzania.
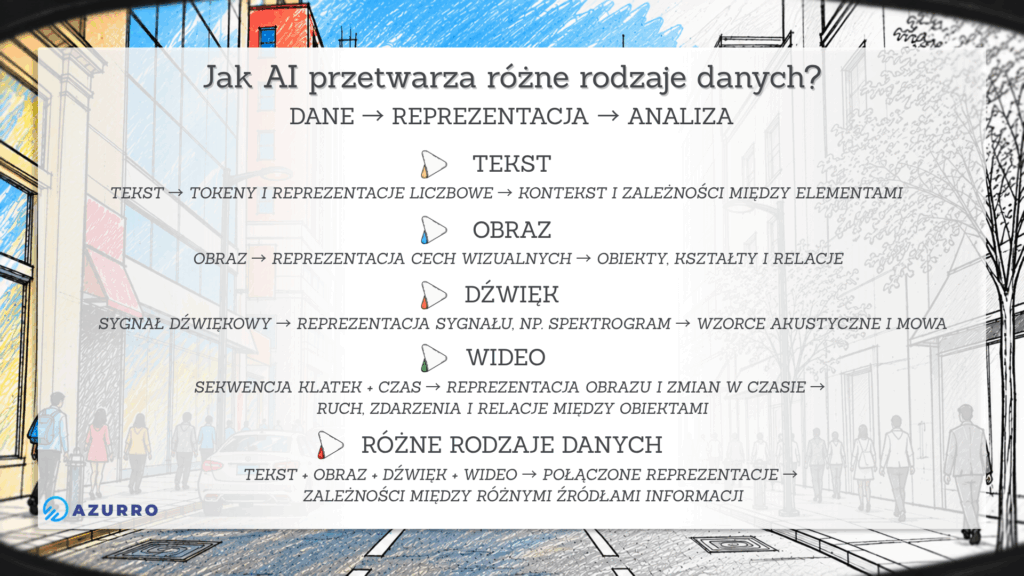
Tekst, obraz, dźwięk czy wideo wymagają odpowiedniej reprezentacji, która pozwala modelowi wykrywać zależności w danych. To właśnie sposób, w jaki informacje są reprezentowane i przetwarzane, decyduje o tym, co model może z nimi zrobić. Jak wygląda ten proces w przypadku różnych rodzajów danych? Tego dowiecie się z tego artykułu. Zapraszamy!
Przetwarzanie tekstu
Dla człowieka tekst jest zbiorem słów i zdań, które odczytujemy i interpretujemy niemal automatycznie. Dla modelu językowego punktem wyjścia jest ciąg danych, który trzeba najpierw podzielić na mniejsze elementy. Służy do tego tokenizacja. Token nie musi odpowiadać całemu słowu. Może być jego fragmentem lub pojedynczym znakiem. Sposób podziału zależy od zastosowanego tokenizera i języka.
Po tokenizacji tekst zostaje przedstawiony w postaci, którą model może matematycznie przetwarzać. Poszczególne tokeny są powiązane z reprezentacjami liczbowymi, a model podczas działania uwzględnia ich wzajemne relacje i położenie w sekwencji. Dzięki temu nie analizuje każdego fragmentu tekstu w całkowitym oderwaniu od pozostałych. Znaczenie słowa lub fragmentu wypowiedzi zależy również od kontekstu, w którym się pojawia.
To właśnie kontekst jest jednym z kluczowych elementów współczesnych modeli językowych. To samo słowo może oznaczać coś innego w zależności od sąsiednich słów i całego zdania. Model nie przechowuje po prostu słownika znaczeń, w którym każdemu słowu odpowiada jedna definicja. Uczy się zależności występujących w dużych zbiorach tekstów i wykorzystuje je do określania, jakie informacje są ważne w danym fragmencie.
Dzięki temu model może wykonywać zadania takie jak odpowiadanie na pytania, tłumaczenie, streszczanie czy generowanie tekstu. Podstawowa zasada pozostaje jednak ta sama: tekst musi zostać zamieniony na reprezentację, z którą model może pracować. Kiedy użytkownik wpisuje pytanie, model analizuje jego reprezentację w kontekście całej dostępnej sekwencji, a następnie generuje odpowiedź token po tokenie.
Jak sztuczna inteligencja “widzi” obraz?
Obraz, który dla człowieka jest całością przedstawiającą konkretną scenę, dla modelu jest uporządkowanym zbiorem wartości opisujących piksele. Model AI musi przekształcić tę informację do reprezentacji, na której może wykonywać dalsze operacje. Nie oznacza to jednak prostego „odczytania” każdego piksela z osobna. Model uczy się wzorców występujących w obrazach i zależności między ich elementami, dzięki czemu może rozpoznawać między innymi kształty, obiekty czy charakterystyczne cechy sceny.
Obraz jest zamieniany na reprezentację liczbową, często określaną jako embedding. Można ją wyobrazić sobie jako punkt w wielowymiarowej przestrzeni, w której obrazy lub ich elementy o podobnych cechach mogą znajdować się bliżej siebie. Taka reprezentacja nie jest jednak gotową etykietą w rodzaju „to jest pies” – zawiera informacje, które model może wykorzystać do rozpoznawania i porównywania treści. Google DeepMind pokazuje, że organizacja takich reprezentacji może różnić się od ludzkiego sposobu kategoryzowania obrazów. Model może zwracać większą uwagę na cechy powierzchniowe, takie jak kolor czy tekstura, podczas gdy człowiek kieruje się bardziej abstrakcyjnymi podobieństwami.
To ważna różnica między ludzkim widzeniem a analizą obrazu przez AI. Człowiek nie musi zamieniać świadomie obrazu na liczbową reprezentację, aby rozpoznać samochód stojący na ulicy. Model operuje na wyuczonych reprezentacjach, które pozwalają mu wiązać cechy wizualne z pojęciami i wykonywać określone zadania. Co więcej, reprezentacje wizualne mogą być łączone z reprezentacjami językowymi. W vision-language models (VLM) obrazy i tekst są mapowane do wspólnej przestrzeni reprezentacji, co pozwala modelowi łączyć informacje pochodzące z obu źródeł.
Dzięki temu model może nie tylko rozpoznać, co znajduje się na obrazie, ale także odpowiadać na pytania dotyczące jego zawartości, tworzyć opis obrazu czy zestawiać informacje wizualne z tekstem. Przejście od samych cech obrazu do reprezentacji, które można powiązać z pojęciami i językiem, jest jednym z ważnych kroków w kierunku rozwoju modeli multimodalnych.
Jaki sztuczna inteligencja “słyszy” dźwięk?
Dźwięk jest dla człowieka doświadczeniem słuchowym, ale dla komputera jest sygnałem zapisanym w postaci danych. Mikrofon zamienia zmiany ciśnienia powietrza na sygnał, który następnie jest próbkowany i zapisywany jako ciąg wartości. Taki zapis opisuje, jak sygnał zmienia się w czasie. Sam ciąg próbek nie jest jednak jeszcze tym, co model AI musi „zrozumieć”. Aby łatwiej analizować charakterystyczne cechy dźwięku, sygnał można przekształcić do innej reprezentacji.
Jedną z takich reprezentacji jest spektrogram, który pokazuje, jak częstotliwości obecne w sygnale zmieniają się w czasie. Można go przedstawić jako wykres: jedna oś odpowiada czasowi, druga częstotliwości. Dzięki temu model otrzymuje informację nie tylko o samym sygnale, ale także o tym, jak jego charakter zmienia się w kolejnych chwilach. Spektrogramy są wykorzystywane między innymi w zadaniach związanych z rozpoznawaniem mowy i klasyfikacją dźwięków.
W przypadku mowy takie reprezentacje pozwalają modelom uczyć się wzorców związanych z ludzkim głosem. Nie chodzi przy tym wyłącznie o rozpoznawanie pojedynczych dźwięków. Występujące po sobie fragmenty sygnału zawierają informacje potrzebne do rozpoznania głosek, słów i całych wypowiedzi. Model może nauczyć się zależności pomiędzy cechami akustycznymi a odpowiadającymi im elementami języka. W podobny sposób modele audio mogą być trenowane do rozpoznawania innych rodzajów dźwięków, na przykład muzyki czy odgłosów otoczenia
Przykładem jest Whisper, model automatycznego rozpoznawania mowy opracowany przez OpenAI. W jego przypadku wejściowy dźwięk jest dzielony na fragmenty, a następnie przekształcany do postaci spektrogramu log-Mel, który trafia do kodera modelu. Na tej podstawie system generuje tekst odpowiadający rozpoznanej mowie. Model może również identyfikować język, dodawać znaczniki czasu i wykonywać tłumaczenie mowy na język angielski.
AI nie „słyszy” więc słów w taki sposób jak człowiek. Otrzymuje reprezentację sygnału i na jej podstawie rozpoznaje wzorce, które podczas treningu powiązała z określonymi dźwiękami, słowami czy innymi cechami nagrania. Podobnie jak w przypadku obrazu, kluczowe znaczenie ma nie tylko sam rodzaj danych, ale także sposób, w jaki zostaną one przedstawione modelowi.
Analiza wideo
Wideo można potraktować jako szczególny przypadek obrazu: zamiast pojedynczej klatki model otrzymuje ich sekwencję uporządkowaną w czasie. Każda klatka zawiera informacje takie jak obiekty, kształty czy kolory, ale dopiero zestawienie kolejnych klatek pozwala uchwycić ruch i zmiany zachodzące w scenie. Model musi więc uwzględnić nie tylko to, co znajduje się w danym momencie na obrazie, ale także to, co wydarzyło się chwilę wcześniej i jak sytuacja rozwija się dalej.
Ta dodatkowa informacja sprawia, że analiza wideo jest bardziej złożona niż analiza pojedynczego obrazu. W nagraniu może być wiele klatek przedstawiających niemal tę samą scenę, a jednocześnie ważne zdarzenie może trwać zaledwie kilka sekund. Dlatego modele analizujące wideo nie zawsze mogą traktować wszystkie klatki jednakowo. Jednym z problemów badawczych jest wybór tych fragmentów nagrania, które zawierają najważniejsze informacje. Odpowiedni dobór klatek i uwzględnienie zależności czasowych może mieć istotne znaczenie dla jakości rozumienia nagrania.
Ważne jest również to, że model może tworzyć reprezentację obejmującą nie tylko pojedyncze obrazy, ale relacje zachodzące w przestrzeni i czasie. Przykładem jest InternVideo-Next, model zaprojektowany do uczenia reprezentacji wideo, które zachowują zarówno szczegóły wizualne, jak i bardziej abstrakcyjne informacje dotyczące ruchu, geometrii 3D czy fizycznych cech obserwowanej sceny. W tym podejściu model uczy się przewidywać informacje w przestrzeni reprezentacji, zamiast skupiać się wyłącznie na odtwarzaniu pojedynczych pikseli.
Analiza wideo może więc obejmować nie tylko rozpoznanie obiektów czy osób, ale także określenie, co się wydarzyło, w jakiej kolejności i jakie elementy sceny są ze sobą powiązane. Wideo dostarcza modelowi informacji o świecie w kolejnych momentach, dzięki czemu może on analizować zdarzenia jako proces, a nie zbiór niezależnych obrazów. Wymiar czasowy jest tym, co odróżnia analizę wideo od zwykłego rozpoznawania zawartości pojedynczego zdjęcia.
Połączenie różnych rodzajów danych
Tekst, obraz, dźwięk i wideo można analizować osobno, ale informacje pochodzące z różnych źródeł często uzupełniają się nawzajem. Człowiek może jednocześnie zobaczyć osobę mówiącą, usłyszeć jej wypowiedź i odczytać znajdujący się obok niej napis. Modele multimodalne mają podobną możliwość łączenia informacji, choć robią to poprzez przetwarzanie różnych rodzajów danych w odpowiednich reprezentacjach.
W modelu multimodalnym różne rodzaje danych muszą zostać ze sobą powiązane. Obraz może dawać informacje o wyglądzie obiektu, tekst o jego nazwie lub właściwościach, a dźwięk o tym, co dzieje się w nagraniu. Modele uczą się zależności między takimi informacjami, dzięki czemu mogą wykorzystywać je wspólnie zamiast analizować każdy rodzaj danych całkowicie niezależnie. W zależności od rozwiązania mogą być one mapowane do wspólnej przestrzeni reprezentacji albo łączone na późniejszych etapach przetwarzania.
Przykładem jest sytuacja, w której model otrzymuje zdjęcie i pytanie zapisane w języku naturalnym. Sama analiza obrazu pozwala określić, co się na nim znajduje, a analiza tekstu wskazuje, o jaki aspekt obrazu pyta użytkownik. Połączenie obu informacji pozwala wygenerować odpowiedź odnoszącą się bezpośrednio do zawartości zdjęcia. Podobny mechanizm można wykorzystać w przypadku wideo, gdzie oprócz obrazu istotne mogą być wypowiadane słowa, napisy czy inne dźwięki.
Współczesne modele coraz częściej są projektowane właśnie z myślą o takiej wspólnej analizie. Nie chodzi jednak o to, że wszystkie rodzaje danych są przetwarzane w identyczny sposób. Tekst, obraz i dźwięk mają różną strukturę, dlatego każdy z nich wymaga odpowiedniego sposobu reprezentacji. Kluczowe jest natomiast stworzenie takich reprezentacji i mechanizmów ich łączenia, które pozwolą modelowi wykorzystywać informacje pochodzące z różnych źródeł w ramach jednego zadania.
To prowadzi do szerszego rozumienia tego, czym jest „widzenie” czy „słyszenie” przez AI. Model nie otrzymuje świata w takiej postaci, w jakiej doświadcza go człowiek. Otrzymuje różne rodzaje danych, przekształca je do postaci, na której może działać, a następnie poszukuje zależności między nimi. Im więcej informacji może połączyć i im lepiej potrafi zachować relacje między nimi, tym bardziej złożone zadania może wykonywać.
Podsumowanie
Sztuczna inteligencja nie odbiera świata tak jak człowiek, ale potrafi przetwarzać wiele rodzajów informacji, jeśli zostaną odpowiednio przedstawione. Tekst jest dzielony na tokeny, obraz i dźwięk są zamieniane na reprezentacje pozwalające wykrywać ich charakterystyczne cechy, a wideo dodatkowo daje informacje o zmianach zachodzących w czasie.
Największe możliwości pojawiają się, gdy model może łączyć różne rodzaje danych. Informacje z obrazu, tekstu, dźwięku czy wideo mogą być ze sobą powiązane, dzięki czemu model analizuje nie tylko pojedyncze elementy, ale także relacje między nimi. To właśnie na tym polega istota multimodalnego przetwarzania informacji. AI nie „widzi” ani „słyszy” świata w ludzkim znaczeniu tych słów. Operuje na reprezentacjach danych i wyuczonych zależnościach, które pozwalają rozpoznawać wzorce, łączyć informacje i wykonywać coraz bardziej złożone zadania.