Sztuczna inteligencja potrafi w kilka sekund przygotować odpowiedź, która brzmi logicznie, spójnie i przekonująco. Problem pojawia się wtedy, gdy ta odpowiedź jest nieprawdziwa. Model może podać zmyślone źródło, pomylić fakty, błędnie zinterpretować pytanie albo połączyć prawdziwe informacje w niepoprawny sposób. Takie sytuacje określa się mianem halucynacji.
Skąd biorą się te błędy? Dlaczego model czasami nie mówi „nie wiem”, tylko tworzy odpowiedź, która brzmi naprawdę przekonująco? I czy większa ilość danych oraz coraz nowsze modele wystarczą, aby problem zniknął? Aby to zrozumieć, trzeba wiedzieć, jak AI uczy się informacji, jak je przetwarza i w jaki sposób powstaje ostateczna odpowiedź.
Sztuczna inteligencja nie zawsze wie, że się myli
Halucynacja nie oznacza, że model świadomie podaje nieprawdę. Model nie ma prostego mechanizmu, który przy każdej wygenerowanej informacji sprawdzałby: „czy to jest prawda?”. Może więc wygenerować treść, która dobrze pasuje do pytania i brzmi wiarygodnie, mimo że nie ma wystarczających podstaw, by uznać ją za prawdziwą.
Problem ten występuje także w najnowszych modelach. W Stanford AI Index Report 2026 opisano, że halucynacje pozostają jednym z istotnych wyzwań związanych z wiarygodnością systemów AI. Badania opublikowane w Nature w 2026 roku pokazują, że modele mogą tworzyć przekonujące, ale fałszywe odpowiedzi nawet wtedy, gdy są już bardzo zaawansowane.
Dlatego błąd AI jest czymś innym niż zwykła pomyłka w programie komputerowym. Model nie otrzymuje po prostu gotowej bazy faktów, z której wybiera właściwą odpowiedź. Generuje ją na podstawie zależności, których nauczył się podczas treningu. Żeby zrozumieć, dlaczego czasami prowadzi to do podawania przez model nieprawdziwych informacji, trzeba najpierw przyjrzeć się temu, czego właściwie model uczy się z danych.
Czego właściwie uczy się model?
Model językowy nie uczy się informacji w taki sam sposób jak człowiek uczący się z podręcznika. Podczas treningu otrzymuje ogromne ilości tekstów i uczy się zależności występujących między ich elementami. W uproszczeniu jego zadaniem jest przewidywanie, jaki element tekstu powinien pojawić się w danym miejscu. Dzięki temu z czasem rozpoznaje wzorce językowe, zależności między pojęciami i sposoby, w jakie informacje są ze sobą powiązane.
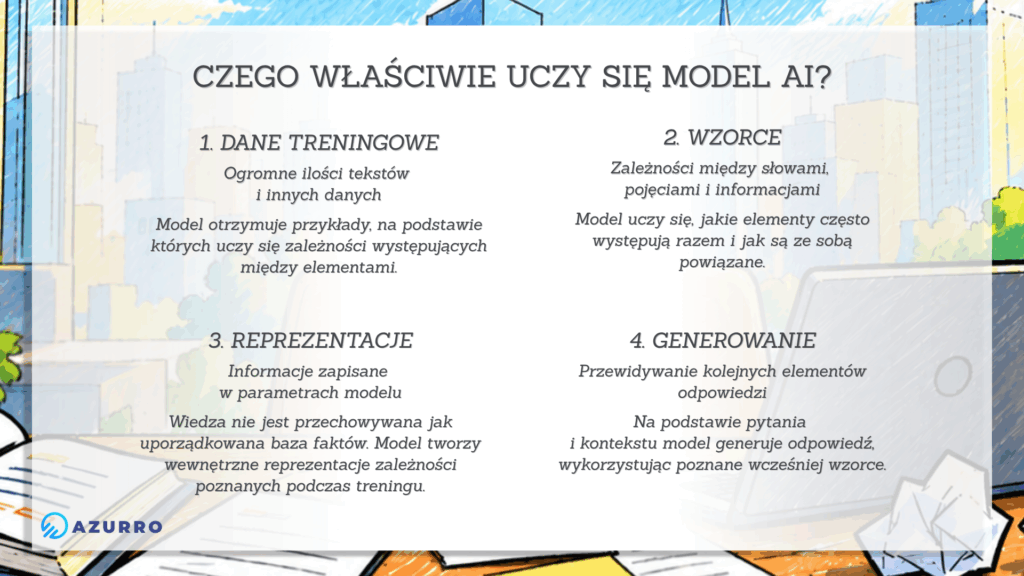
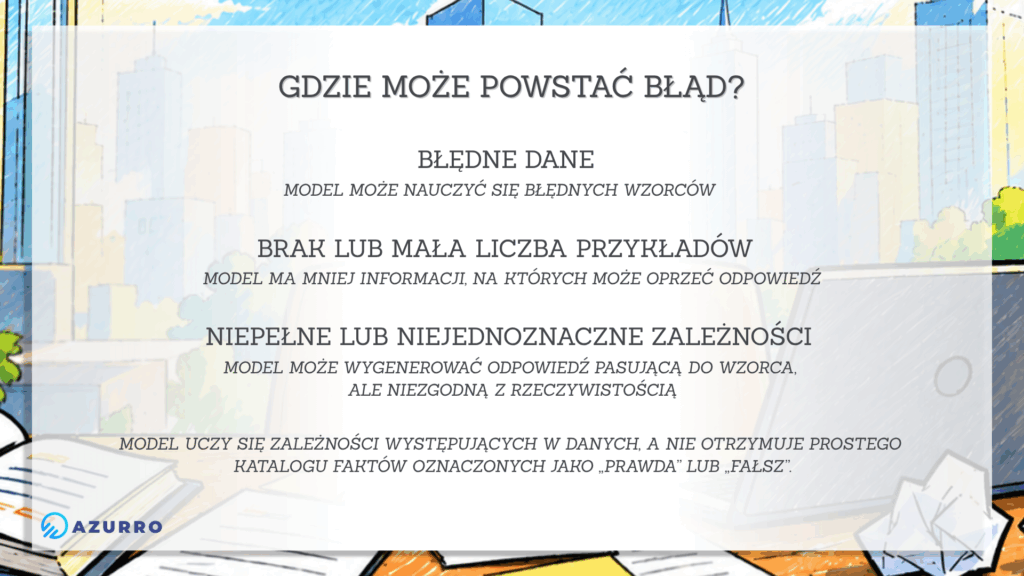
Jednak nie oznacza to, że każda informacja zapisana w danych treningowych zostaje przez model oznaczona jako prawdziwa. W samych danych mogą znajdować się błędy, sprzeczne informacje, nieaktualne treści czy teksty powtarzające nieprawdziwe twierdzenia. Model uczy się również tych wzorców. Nie ma przy tym prostego mechanizmu, który przy każdym poznanym fakcie przypisywałby mu etykietę „prawda” albo „fałsz”.
Ma to znaczenie wtedy, gdy użytkownik pyta np. o coś rzadkiego, mało opisanego lub niejednoznacznego. Jeśli w danych treningowych brakuje wystarczającej liczby podobnych przykładów, model ma mniej informacji, na których może oprzeć odpowiedź. Może wtedy wygenerować treść, która pasuje do poznanych wcześniej wzorców językowych, choć nie odpowiada rzeczywistości.
Dlatego płynność odpowiedzi nie jest dowodem jej poprawności. Model może bardzo dobrze rozpoznawać, jak powinna wyglądać odpowiedź, nawet jeśli nie ma wystarczających podstaw, by stwierdzić, jaka powinna być jej treść. To jedna z przyczyn, dla których odpowiedź AI może brzmieć przekonująco, a jednocześnie zawierać błąd.
Model może wiedzieć więcej, niż pokazuje
Można by założyć, że jeśli model udziela błędnej odpowiedzi, oznacza to po prostu, że nie zna właściwej informacji. Badania Google Research nad dużymi modelami językowymi pokazują jednak, że sprawa może być bardziej złożona. Jedno z tych badań wykazało, że wewnętrzne reprezentacje modeli mogą zawierać informacje pozwalające rozróżnić prawdziwe i fałszywe odpowiedzi. Autorzy zaobserwowali również przypadki, w których model znał poprawną odpowiedź, a mimo to generował odpowiedź błędną.
Inne badanie przeprowadzone przez Google Research pokazało, że model może czasami wydobyć wcześniej niedostępną mu bezpośrednio informację dzięki wygenerowaniu dodatkowego toku rozumowania. Dotyczyło to nawet prostych pytań, które nie wymagały skomplikowanych obliczeń ani wieloetapowego wnioskowania. Autorzy wskazali, że generowanie powiązanych faktów może ułatwiać modelowi dotarcie do właściwej odpowiedzi.
To oznacza, że odpowiedź modelu nie jest prostym odczytem tego, „co znajduje się w jego pamięci”. Pomiędzy informacją zakodowaną w parametrach a ostateczną odpowiedzią zachodzi proces generowania, na który wpływa między innymi pytanie, kontekst i sposób rozumowania.
Błąd modelu może więc wynikać nie tylko z tego, że nie ma potrzebnej wiedzy, ale również z tego, że nie potrafił jej wykorzystać w konkretnej sytuacji. Co więcej, sama próba wydobycia informacji może wprowadzić kolejny błąd, jeśli model zacznie opierać się na nieprawdziwych faktach.
Dlaczego AI zgaduje zamiast powiedzieć „nie wiem”?
Skoro model nie zawsze ma wystarczające informacje, naturalnym rozwiązaniem wydawałoby się przyznanie: „nie wiem”. Tymczasem modele językowe często próbują odpowiedzieć mimo braku pewności. Jedną z przyczyn może być sposób, w jaki są trenowane i oceniane. Jeśli za odpowiedź przyznaje się punkty przede wszystkim wtedy, gdy jest poprawna, a błędna odpowiedź jest traktowana podobnie jak brak odpowiedzi, model może mieć niewiele powodów, by powstrzymywać się od zgadywania.
Jak już wspomnieliśmy wcześniej, problem ten został opisany w badaniu opublikowanym w Nature w 2026 roku. Autorzy pokazali, że popularne sposoby oceniania modeli mogą tworzyć zachętę do udzielania odpowiedzi nawet wtedy, gdy model nie ma wystarczających podstaw, by być pewnym ich poprawności. W takiej sytuacji model może „zaryzykować” odpowiedź, ponieważ jej potencjalna korzyść jest większa niż w przypadku całkowitego powstrzymania się od odpowiedzi.
Nie oznacza to, że modele zostały po prostu „nauczone kłamać”. Model nie podejmuje świadomej decyzji o ukryciu swojej niewiedzy. Chodzi raczej o to, że podczas treningu i późniejszego dostrajania może nauczyć się wzorca, w którym udzielenie odpowiedzi jest preferowane nad powstrzymaniem się od niej.
Dlatego ograniczenie halucynacji wymaga więcej niż dostarczenia modelowi większej ilości danych. Ważne jest również nauczenie go rozpoznawania sytuacji, w których jego wiedza lub pewność są niewystarczające. A to prowadzi do kolejnego problemu: nawet jeśli model podejmuje próbę rozwiązania zadania, może popełnić błąd już na etapie łączenia informacji i budowania odpowiedzi.
Błąd w rozumowaniu
Nawet jeśli model ma potrzebne informacje, nie musi poprawnie wykorzystać ich do rozwiązania zadania. Problem może pojawić się w trakcie samego rozumowania, szczególnie gdy odpowiedź wymaga wykonania kilku kolejnych kroków. Jeden błędny krok może wpłynąć na wszystkie następne i doprowadzić do niepoprawnego wyniku, mimo że poszczególne elementy odpowiedzi mogą brzmieć logicznie.
Badania nad sposobem, w jaki modele rozwiązują zadania wieloetapowe, pokazują, że takie błędy często pojawiają się stosunkowo wcześnie. Analiza opublikowana w ACL Anthology wykazała, że w wielu przypadkach model zaczyna podążać niewłaściwą ścieżką w jednym z początkowych etapów, a późniejsze rozumowanie pozostaje spójne, ale prowadzi już do błędnego rozwiązania.
To pokazuje, dlaczego samo wydłużanie procesu rozumowania nie zawsze rozwiązuje problem. Model może wykonać więcej kroków, ale jeśli wcześnie przyjmie błędne założenie, kolejne kroki mogą jedynie konsekwentnie rozwijać ten błąd. Rozumowanie AI nie jest więc gwarancją poprawności. Może być długie i szczegółowe, a mimo to prowadzić do nieprawidłowego wyniku.
Dlaczego AI brzmi pewnie, nawet gdy się myli?
Nawet jeśli model nie ma pewności co do odpowiedzi, użytkownik nie zawsze jest w stanie to zauważyć. Wynika to między innymi z tego, że sposób formułowania odpowiedzi nie musi odzwierciedlać rzeczywistej pewności modelu. AI może przedstawić błędną informację w przekonujący sposób, bez wyraźnego sygnału, że odpowiedź jest niepewna.
Pomaga to zrozumieć pojęcie kalibracji modelu. W uproszczeniu chodzi o zgodność między pewnością modelu a rzeczywistą poprawnością odpowiedzi. Jeśli model ocenia swoje odpowiedzi na 80 proc. pewności, dobrze skalibrowany system powinien być poprawny mniej więcej w 80 proc. takich przypadków. Jeśli natomiast często podaje wysoką pewność przy błędnych odpowiedziach, jest nadmiernie pewny siebie. Kalibracja nie mówi więc, czy pojedyncza odpowiedź jest prawdziwa, a pokazujej, czy poziom pewności modelu jest wiarygodnym sygnałem jego poprawności.
Ta zgodność może być problemem. W badaniu opublikowanym przez MIT naukowcy wykazali, że popularne metody szacowania niepewności mogą nie wykrywać sytuacji, w których model jest przekonany o odpowiedzi, mimo że jest ona błędna. Zaproponowana przez nich metoda wykorzystuje między innymi różnice między odpowiedziami kilku podobnych modeli, aby lepiej rozpoznawać takie przypadki.
Jeszcze inne badanie zespołu MIT pokazało, że standardowe uczenie ze wzmocnieniem może poprawiać skuteczność modeli, a jednocześnie pogarszać ich kalibrację. Autorzy zaproponowali metodę, która podczas treningu nagradza nie tylko poprawną odpowiedź, ale również trafne oszacowanie własnej pewności. W eksperymentach pozwoliło to znacznie ograniczyć błędy kalibracji bez pogorszenia dokładności.
Ten problem jest ważny dlatego, że dla użytkownika sama poprawność odpowiedzi nie zawsze jest wystarczająca. Jeśli model potrafi również wiarygodnie sygnalizować swoją niepewność, łatwiej zdecydować, kiedy warto dodatkowo sprawdzić odpowiedź. Dlatego jednym z kierunków rozwoju modeli jest nie tylko zwiększanie ich dokładności, ale także lepsze rozpoznawanie sytuacji, w których nie powinny być zbyt pewne siebie.
Jak ogranicza się błędy AI?
Skoro błędy mogą powstawać na różnych etapach, np. przy przygotowywaniu danych treningowych, wydobywaniu informacji i rozumowaniu czy przy samym generowaniu odpowiedzi, nie istnieje jedna metoda, która rozwiązuje ten problem. Dlatego obecnie wykorzystuje się kilka uzupełniających się sposobów ograniczania błędów.
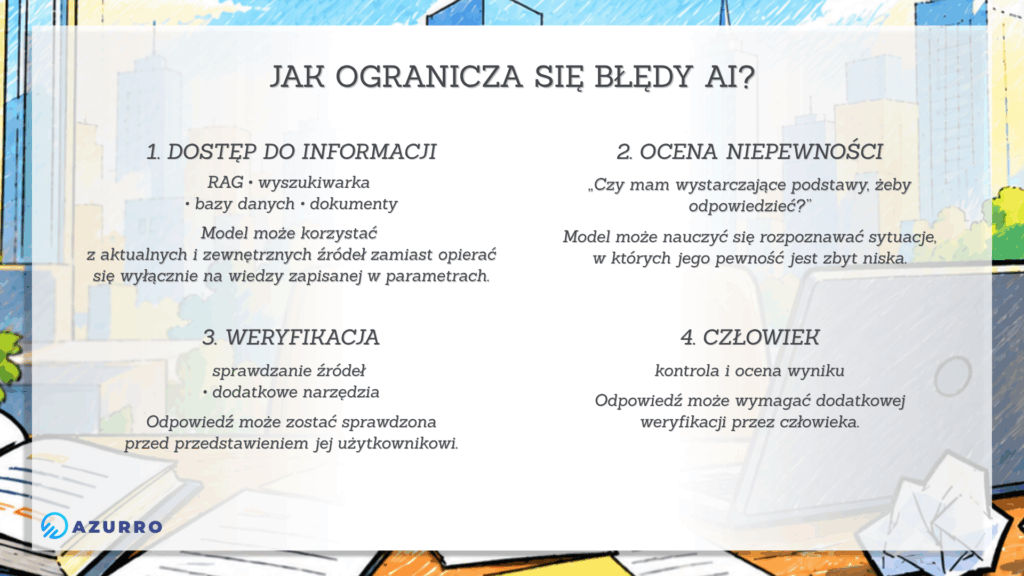
Jednym z nich jest dostęp do zewnętrznych źródeł informacji. Zamiast opierać odpowiedź wyłącznie na wiedzy zapisanej w parametrach modelu, system może wyszukać potrzebne informacje w dokumentach, bazach danych lub internecie. Tak działają między innymi systemy RAG. Pozwala to oprzeć odpowiedź na konkretnych źródłach, choć samo wyszukanie informacji nie gwarantuje jeszcze, że model poprawnie je zinterpretuje.
Drugim kierunkiem jest uczenie modelu rozpoznawania własnej niepewności. Jeśli system potrafi wykryć, że nie ma wystarczających podstaw do udzielenia odpowiedzi, może zamiast zgadywać poprosić o dodatkowe informacje, odmówić odpowiedzi albo zaznaczyć, że wynik wymaga weryfikacji. Wcześniej wspomniane badania nad kalibracją i metodami wykrywania nadmiernej pewności pokazują, że jest to osobny problem.
Ważne jest również sprawdzanie odpowiedzi. Model może korzystać z dodatkowych narzędzi, wykonywać obliczenia, porównywać informacje z kilkoma źródłami albo przekazywać wynik do kolejnego etapu weryfikacji. W systemach, w których błędna odpowiedź może mieć poważne konsekwencje, człowiek nadal powinien weryfikować odpowiedzi systemu.
Ograniczanie błędów AI nie polega więc na znalezieniu jednego sposobu na „naprawienie” modelu. Chodzi o budowanie systemu, w którym model ma dostęp do odpowiednich informacji, potrafi sygnalizować niepewność i może sprawdzić swoje odpowiedzi przed ich przedstawieniem użytkownikowi.
Podsumowanie
Błędy AI nie mają jednej przyczyny. Model może nauczyć się niepoprawnych wzorców z danych, nie wykorzystać wiedzy, którą posiada, obrać błędną ścieżkę podczas rozumowania albo udzielić odpowiedzi mimo zbyt małej pewności. Dodatkowym problemem jest to, że sposób formułowania odpowiedzi nie zawsze pokazuje, jak wiarygodny jest jej wynik.
Dlatego sama płynność i szczegółowość odpowiedzi nie są wystarczającym dowodem jej poprawności. Coraz większe znaczenie ma nie tylko to, jak dobrze model odpowiada, ale również to, czy potrafi rozpoznać własną niepewność, korzystać z odpowiednich źródeł i poddawać wyniki weryfikacji.
Rozwój AI nie polega więc wyłącznie na budowaniu modeli, które odpowiadają coraz lepiej. Równie ważne jest projektowanie systemów, które potrafią ograniczać błędy i pomagać użytkownikowi rozpoznać sytuacje, w których odpowiedź wymaga dodatkowego sprawdzenia.