Współczesne modele sztucznej inteligencji kojarzymy z generowaniem treści. Modele językowe odpowiadają na pytania, podsumowują dokumenty, analizują informacje i tworzą tekst, a modele multimodalne potrafią pracować również z obrazami, dźwiękiem czy wideo. Jednak w wielu systemach AI wygenerowana odpowiedź nie jest celem samym w sobie. System musi na jej podstawie podjąć decyzję, np. wybrać jedną z dostępnych opcji, ocenić poziom ryzyka albo zdecydować, jakie działanie wykonać dalej.
Właśnie na takich zadaniach skupiają się modele określane jako System One. Są one projektowane tak, aby zwracać ustrukturyzowane decyzje, które mogą być bezpośrednio wykorzystane przez inne oprogramowanie. W artykule opisujemy, jak działają oraz jakie zadania mogą wykonywać.
Czym są modele System One?
Modele System One można w skrócie określić jako modele AI zaprojektowane do podejmowania ustrukturyzowanych decyzji. Otrzymują dane wejściowe oraz jasno określone pytanie, a następnie zwracają odpowiedź w ustalonym formacie. W ich przypadku nie chodzi o napisanie tekstu, ale o dostarczenie informacji, na podstawie której inne oprogramowanie może wykonać kolejne działanie.
Decyzja nie musi ograniczać się do wyboru jednej etykiety. Model może zostać poproszony o wybranie jednej z kilku opcji, ocenę czegoś na określonej skali albo odpowiedź na pytanie typu tak/nie. Ważnym elementem są również prawdopodobieństwa przypisane odpowiedziom. Dzięki nim system może uwzględnić nie tylko sam wynik, ale także to, jak pewna jest dana decyzja.
Pomysł na taką kategorię modeli pojawił się we wrześniu 2026 roku za sprawą firmy TypeSafe AI. 15 września firma przedstawiła model Jev, określany przez nią jako pierwszy publiczny model System One, i jednocześnie wprowadziła nazwę całej kategorii. TypeSafe AI opisało ją jako klasę modeli przeznaczonych do szybkiego podejmowania ustrukturyzowanych decyzji, które mogą być bezpośrednio wykorzystywane przez oprogramowanie.
Sama nazwa System One nawiązuje do koncepcji Daniela Kahnemana przedstawionej w książce Thinking, Fast and Slow. Kahneman rozróżniał w niej szybkie, intuicyjne procesy myślowe określane jako System 1 oraz wolniejsze, bardziej analityczne System 2. W przypadku modeli AI nazwa ma podkreślać nacisk na szybkie, wyspecjalizowane decyzje. Nie oznacza to jednak, że modele System One są bezpośrednim odwzorowaniem ludzkiego Systemu 1, jest to raczej inspiracja dla sposobu opisania nowej kategorii modeli.
Ważne jest również odróżnienie takiego modelu od zwykłego modelu językowego korzystającego ze structured output. LLM może wygenerować odpowiedź w postaci JSON-a czy innego określonego formatu, ale jego podstawowym mechanizmem pozostaje generowanie kolejnych tokenów. Model System One jest natomiast projektowany wokół samego zadania decyzyjnego. Możliwe wyniki są z góry określone, a odpowiedź ma być gotową wartością dla programu, a nie tekstem przeznaczonym do odczytania przez człowieka.
Jak działa model decyzyjny?
Model System One otrzymuje informacje, które mają znaczenie dla podejmowanej decyzji, oraz zestaw pytań, na które ma odpowiedzieć. Zamiast prosić go o przygotowanie jednej rozbudowanej odpowiedzi, zadanie można podzielić na kilka mniejszych decyzji. W dokumentacji TypeSafe AI wyróżniono trzy podstawowe typy takich pytań: Choice, Score i Noul.
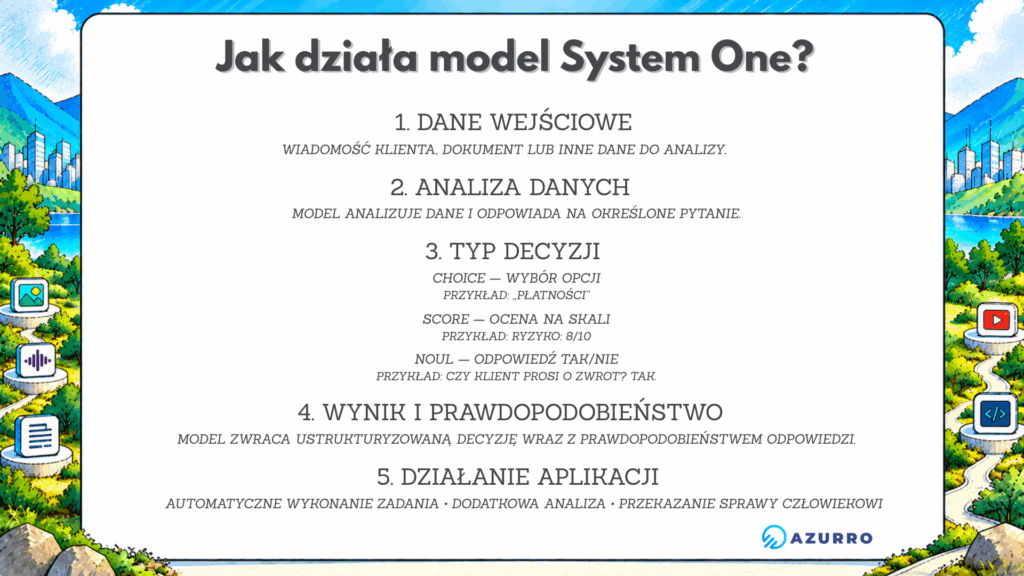
Choice oznacza wybór jednej opcji z wcześniej zdefiniowanego zbioru. Może to być na przykład pytanie, do którego działu należy skierować zgłoszenie: „sprzedaż”, „płatności” czy „wsparcie techniczne”. Model nie musi tworzyć uzasadnienia ani opisywać swojej decyzji. Zwraca wybraną opcję razem z rozkładem prawdopodobieństwa dla dostępnych możliwości.
Score służy do oceniania czegoś na określonej skali. Można na przykład poprosić model o ocenę poziomu frustracji klienta. Wynikiem jest wartość na zdefiniowanej skali, ale również informacja o rozkładzie prawdopodobieństwa i pewności modelu. Nie jest to więc zwykłe przypisanie jednej etykiety, ale próba określenia, gdzie na danej skali znajduje się analizowany przypadek.
Trzecim typem jest Noul, czyli decyzja typu tak/nie. Można w ten sposób zapytać na przykład: „Czy klient prosi o zwrot pieniędzy?” albo „Czy ta wiadomość zawiera próbę obejścia zabezpieczeń?”. Model zwraca prawdopodobieństwo odpowiedzi twierdzącej.
Ważną częścią tego podejścia są prawdopodobieństwa i kalibracja. Model nie powinien jedynie wskazać odpowiedzi, ale także możliwie wiarygodnie określić, jak bardzo jest jej pewny. Jeśli na przykład ocenia, że prawdopodobieństwo określonej decyzji wynosi 95%, system może potraktować ją inaczej niż decyzję, przy której model wskazuje 55%. Nie oznacza to oczywiście, że odpowiedź z prawdopodobieństwem 95% musi być prawidłowa. Kalibracja ma sprawić, aby deklarowana pewność możliwie dobrze odpowiadała rzeczywistej skuteczności modelu.
To prowadzi do jednej z najważniejszych różnic między takim modelem a typowym generatorem tekstu. W przypadku LLM-a program musi najpierw wydobyć potrzebną informację z wygenerowanej odpowiedzi, sprawdzić jej format i dopiero wtedy zdecydować, co zrobić dalej. W modelu System One wynik decyzji jest od początku projektowany jako dane dla programu. Sam model dostarcza element związany z decyzją, natomiast reguły określające, co zrobić z tym wynikiem, pozostają po stronie aplikacji.
Po co System One, skoro mamy LLM-y i klasyfikatory?
Na pierwszy rzut oka modele System One mogą wydawać się rozwiązaniem problemu, który może być rozwiązany za pomocą innych narzędzi. Model językowy może zostać poproszony o sklasyfikowanie tekstu i zwrócenie wyniku w formacie JSON, a klasyczne modele uczenia maszynowego od dawna potrafią przypisywać dane do określonych kategorii. Różnica polega przede wszystkim na tym, jak model jest projektowany i do czego ma służyć jego wynik.
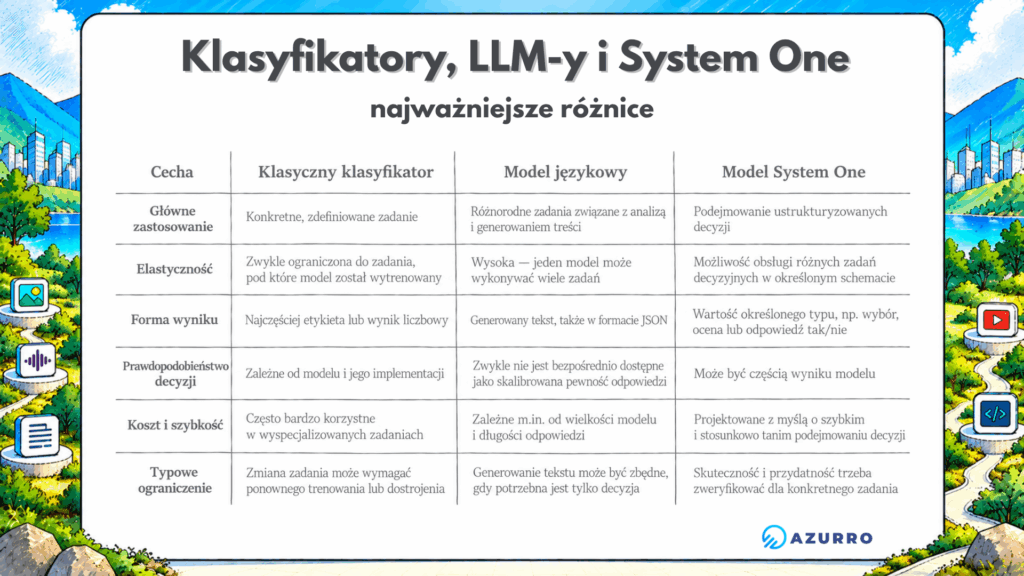
Klasyczny klasyfikator jest zwykle trenowany pod konkretne zadanie. Jeśli chcemy rozpoznawać spam, budujemy model do wykrywania spamu, a jeśli chcemy przypisywać zgłoszenia do działów, przygotowujemy model do klasyfikacji zgłoszeń. Takie rozwiązanie może być bardzo szybkie i skuteczne, ale jego zastosowanie jest zazwyczaj ściśle związane z zadaniem, na którym zostało wytrenowane. Zmiana kryteriów lub kategorii może wymagać zebrania nowych danych i ponownego dostrojenia modelu.
LLM-y są bardziej elastyczne. Ten sam model może analizować różne rodzaje danych i wykonywać wiele zadań bez osobnego trenowania. Można również poprosić go o zwrócenie wyniku w określonym schemacie, na przykład w postaci JSON-a. Problem polega na tym, że taki model nadal generuje odpowiedź token po tokenie. Nawet jeśli końcowym wynikiem ma być jedna etykieta, model wykorzystuje mechanizm zaprojektowany przede wszystkim do generowania sekwencji tekstu. TypeSafe AI wskazuje właśnie ten aspekt jako jedną z głównych różnic między LLM-ami a modelami System One.
W przypadku modeli System One możliwe odpowiedzi są określane z góry, a model zwraca bezpośrednio wartość należącą do zdefiniowanego typu, wraz z prawdopodobieństwami. Nie musi więc generować tekstu, który następnie trzeba przeanalizować i sprawdzić. Upraszcza to połączenie modelu z resztą aplikacji i pozwala wykorzystać jego wynik bezpośrednio w logice programu.
Ważna jest również szybkość i koszt działania. Generowanie dłuższej odpowiedzi przez LLM wymaga kolejnego przetwarzania tokenów, podczas gdy modele System One są projektowane pod kątem bezpośredniego zwracania decyzji. TypeSafe AI deklaruje, że w przypadku Jev czasy odpowiedzi są rzędu dziesiątek lub setek milisekund, oraz że koszt jest znacznie niższy niż w przypadku porównywanych modeli językowych.
Ważną cechą jest także możliwość wykorzystania prawdopodobieństwa decyzji. Klasyczny system może zwrócić jedną etykietę, a LLM tekstową odpowiedź i ewentualnie deklarację pewności, jeśli użytkownik o to poprosi. W modelach System One prawdopodobieństwa są częścią wyniku. Dzięki temu można zbudować prostą logikę: decyzje o wysokiej pewności obsługiwać automatycznie, a najbardziej problematyczne przekazywać człowiekowi. Daje to możliwość tworzenia systemów, w których model decyzyjny pełni funkcję pierwszego etapu selekcji, zamiast zastępować większy model całkowicie.
Pierwsze niezależne badania pokazują jednak, że nie jest to prosty pojedynek, w którym System One wygrywa z LLM-ami. W badaniu obejmującym zadania klasyfikacyjne model decyzyjny osiągał słabsze wyniki niż najlepszy LLM w większości zadań, ale koszt jego wykorzystania był 44 razy niższy. Autorzy pokazali też, że kierowanie przypadków o niskiej pewności do LLM-a może dawać wyniki porównywalne lub lepsze od wykorzystania samego LLM-a przy znacznie niższym koszcie.
Dlatego System One nie powinien być traktowany jako zamiennik ani klasycznych klasyfikatorów, ani modeli językowych. Jego przewagą jest połączenie elastyczności modeli AI z wynikiem zaprojektowanym bezpośrednio do wykorzystania przez inne oprogramowanie. Model System One może sprawdzić się tam, gdzie potrzebna jest szybka i powtarzalna decyzja wraz z informacją o jej pewności. Wybór odpowiedniego rozwiązania zależy od potrzeb konkretnego użytkownika.
Zastosowania modeli decyzyjnych
Modele System One mogą być stosowane w przypadkach, gdy system musi wielokrotnie podejmować określone decyzje. Nie muszą one zastępować głównego modelu AI. Mogą działać jako dodatkowa warstwa, która szybko ocenia dane wejściowe i decyduje, co powinno wydarzyć się dalej.
Jednym z przykładów jest routing, czyli kierowanie zapytań do odpowiedniego miejsca. Model może określić temat i poziom trudności wiadomości, a aplikacja na tej podstawie zdecydować, czy wystarczy zwykłe wyszukanie informacji, prostszy model, mocniejszy LLM czy pomoc człowieka. Dzięki temu nie każde zapytanie musi trafiać do najdroższego modelu.
Podobny mechanizm można wykorzystać w moderacji i systemach bezpieczeństwa. Model może ocenić, czy treść spełnia określone kryteria. Wynik wraz z poziomem pewności może następnie uruchamiać różne ścieżki: automatyczne działanie, dodatkową kontrolę albo przekazanie sprawy człowiekowi.
Kolejnym zastosowaniem jest filtrowanie informacji przed przekazaniem ich do większego modelu. System One może ocenić, które fragmenty dokumentów są istotne dla danego zadania albo czy znaleziony materiał odpowiada określonym kryteriom. W podobny sposób może pełnić funkcję dodatkowej kontroli odpowiedzi wygenerowanej przez LLM.
Modele decyzyjne mogą też współpracować z agentami AI, które muszą wybierać kolejne działania lub narzędzia. Model może zdecydować, którego narzędzia użyć, a następnie agent wykonuje wskazaną operację. Przy zastosowaniach działających w czasie rzeczywistym ważna jest również szybkość takiej decyzji.
Modele System One mogą więc uzupełniać większe systemy AI i przejmować od nich zadania wymagające szybkiego wyboru lub oceny. Nie muszą samodzielnie rozwiązywać całego problemu. Wystarczy, że pomogą zdecydować, który model uruchomić, jakie działanie wykonać albo które przypadki wymagają dodatkowej analizy. To podejście pozwala rozdzielić poszczególne etapy przetwarzania i dopasować używane narzędzia do charakteru zadania.
Czy powstaje nowa kategoria modeli AI?
Choć określenie System One pojawiło się publicznie dopiero we wrześniu 2026 roku, koncepcja szybko zaczęła przyciągać uwagę kolejnych zespołów. Obok modelu Jev powstają rozwiązania rozwijane niezależnie od TypeSafe AI, w tym modele otwarte, które można uruchamiać na własnej infrastrukturze. Przykładem jest GLiNER2.5-Decide, udostępniony przez Fastino Labs we wrześniu 2026 roku. Podobnie jak Jev, jest przeznaczony do zwracania ustrukturyzowanych decyzji. Pojawiają się również kolejne projekty, takie jak Laya, co pokazuje, że nie jest to już wyłącznie eksperyment jednej firmy.
Rozwój tej kategorii nie oznacza jednak, że jej przewaga nad innymi rozwiązaniami została już jednoznacznie potwierdzona. Pierwsze niezależne badania pokazują różne wyniki, zależnie od rodzaju zadań, użytych modeli i metody porównania. W badaniu Evaluating and Benchmarking the System One Model Jev, opublikowanym we wrześniu 2026 roku, autorzy sprawdzili Jev na 37 zbiorach danych obejmujących m.in. klasyfikację, moderację i rozumienie tekstu. Wyniki były konkurencyjne wobec porównywanych modeli językowych, ale badanie dotyczyło konkretnego modelu i określonych warunków testowych, nie dowodzi więc, że wszystkie modele System One będą tak samo skuteczne.
Ważne są też ograniczenia. Jakość decyzji może zależeć od sposobu sformułowania pytania, liczby dostępnych opcji i rodzaju analizowanych danych. Również prawdopodobieństwa zwracane przez model wymagają weryfikacji. Nie należy zakładać, że zawsze są dobrze skalibrowane i można bezpiecznie używać ich jako uniwersalnej miary pewności.
Podsumowanie
Modele System One reprezentują podejście, w którym najważniejszym zadaniem AI nie jest generowanie treści, ale dostarczanie ustrukturyzowanych decyzji gotowych do wykorzystania przez inne oprogramowanie. Mogą być przydatne w sytuacjach, gdy liczą się szybkość działania, koszt i możliwość automatycznego kierowania kolejnych etapów przetwarzania.
Nie oznacza to, że zastąpią modele językowe czy klasyczne klasyfikatory. Każde z tych rozwiązań ma inne mocne strony, a wybór zależy od charakteru zadania. System One to na razie nowa kategoria narzędzi, której wartość pokażą dalsze testy i praktyczne wdrożenia.